在 Agent 动手改字段之前,先回答一句:谁会挂?
Agent 把交付速度抬上去之后,数据库变更的风险也跟着变了:不再只是「改错了」,而是「没人能看全」。当数据流穿过三套数据库、十几个视图和一张仓库代码里从没出现过的报表时,「这次改动会碰到谁」就成了必须先回答的问题——跨实例的列级血缘,是回答它的方式。
约 11 分钟 Agent 列级血缘 MCP
一个一路绿灯的变更
先做一次推演。
Agent 接到一个很小的任务:把商城订单表的净额字段 net_amount 从「下单时算一次」改成「退款后重算」。它读了仓库,改了 ORM 模型,改了一条迁移脚本,改了应用层逻辑,补上测试,提交。CI
全绿,评审五分钟通过——评审的人看到的是一份自洽的 diff。
两周后的某个凌晨,数仓的日调度失败了。
原因不在这次提交的任何一行代码里。订单表在 MySQL,数仓在 PostgreSQL,服务层在 StarRocks。三者之间没有外键、没有跨库约束,把它们连起来的是十几条视图与物化视图的定义、几个调度任务,以及一些被写在 wiki、报表工具和上游应用里的 SQL。
Agent 改的那一列,过了数仓还叫
net_amount,接着一次分出 balance_due、payment_coverage、month_net_rank,被聚合成 net_line_amount
喂给区域日报,又算成客户标签 is_vip,到服务层变成 revenue_tier。
没有任何一个仓库能同时看到链条的两端。评审的人看得见的那半张图,恰好不包含会挂的那部分。
为什么 Agent 让这件事更危险
有三件事同时发生了。
第一,写变更的速度和读懂变更的速度分开了。Agent 让单位时间能落地的变更多了一个量级,而能判断「这次变更会不会伤到别人」的人没有变多。评审带宽成了瓶颈之后,评审很容易退化成「看起来对」:语法没问题、测试是绿的、字段名合理。以前一天几个变更,你还能顺手问一句数仓的同事;现在没有人会问,也没人有空答。
第二,Agent 的可见边界就是它的工作目录。你给它一个仓库,它就能读遍这个仓库;它读不到的是:视图定义躺在数据库里,报表 SQL 躺在 BI 工具里,调度任务里的语句躺在编排系统里,另一套引擎里的物化视图躺在另一个进程里。这些东西通常不在你正在改的那个仓库里,一次全库搜索扫不到它们。Agent 不是不谨慎,它只是只能看到你给它的那部分世界。
第三,数据库变更是少数不能靠回滚解决的操作。代码可以
revert,DROP COLUMN
之后数据就没了。更麻烦的是时滞:变更当天一切正常,故障在下一个调度周期才浮出来,而出故障的地方和发生改动的那个仓库之间没有任何引用关系,排查要从零开始。
为什么读 diff、grep 代码都救不了
面对「这个字段改了会怎样」,直觉上有两种办法:把 diff 读得更仔细,或者把代码搜得更彻底。这两种都不够。
- 名字会变。数据每经过一层就换一次名字,这是数仓的常态,也是重命名最危险的地方:
net_amount在下游留下了 15 个字段名,包括balance_due、payment_coverage、month_net_rank、lifetime_net、avg_order_value、revenue_tier。按名字搜索只能找到同名的那一个;剩下的名字,要靠人想起来。 - 跨引擎没有共同的地基。MySQL 的 schema 和 PostgreSQL 的 schema 之间没有约束、没有类型检查、没有能跳转的引用关系——表名和列名本身就是跨系统的接口,而这个接口没有编译器。它们之间唯一的联系是「数据实际从这边流到了那边」。
- 搜索找的是文本,不是流向。一段 SQL 里出现某个列名,不代表它读了这个列(可能是注释、可能是别名、可能根本没被执行);反过来,一列完全可能没出现在任何你能搜到的文本里,却真实地流向了下游。
要把这些问题一次答完,需要的不是更聪明的搜索,而是一张图:从元数据、SQL 定义与调度事件里推导出来的、精确到列的、跨实例的数据流图。
一张表的链路到底有多长
下面这些数字,来自一套真实跑起来的环境:MySQL 8.4 上的商城库
shop,PostgreSQL 16 上的数仓(ods / dwd
/ ads 三层),StarRocks 4.1 上的服务层,中间由四条 Airflow
管道串起来。
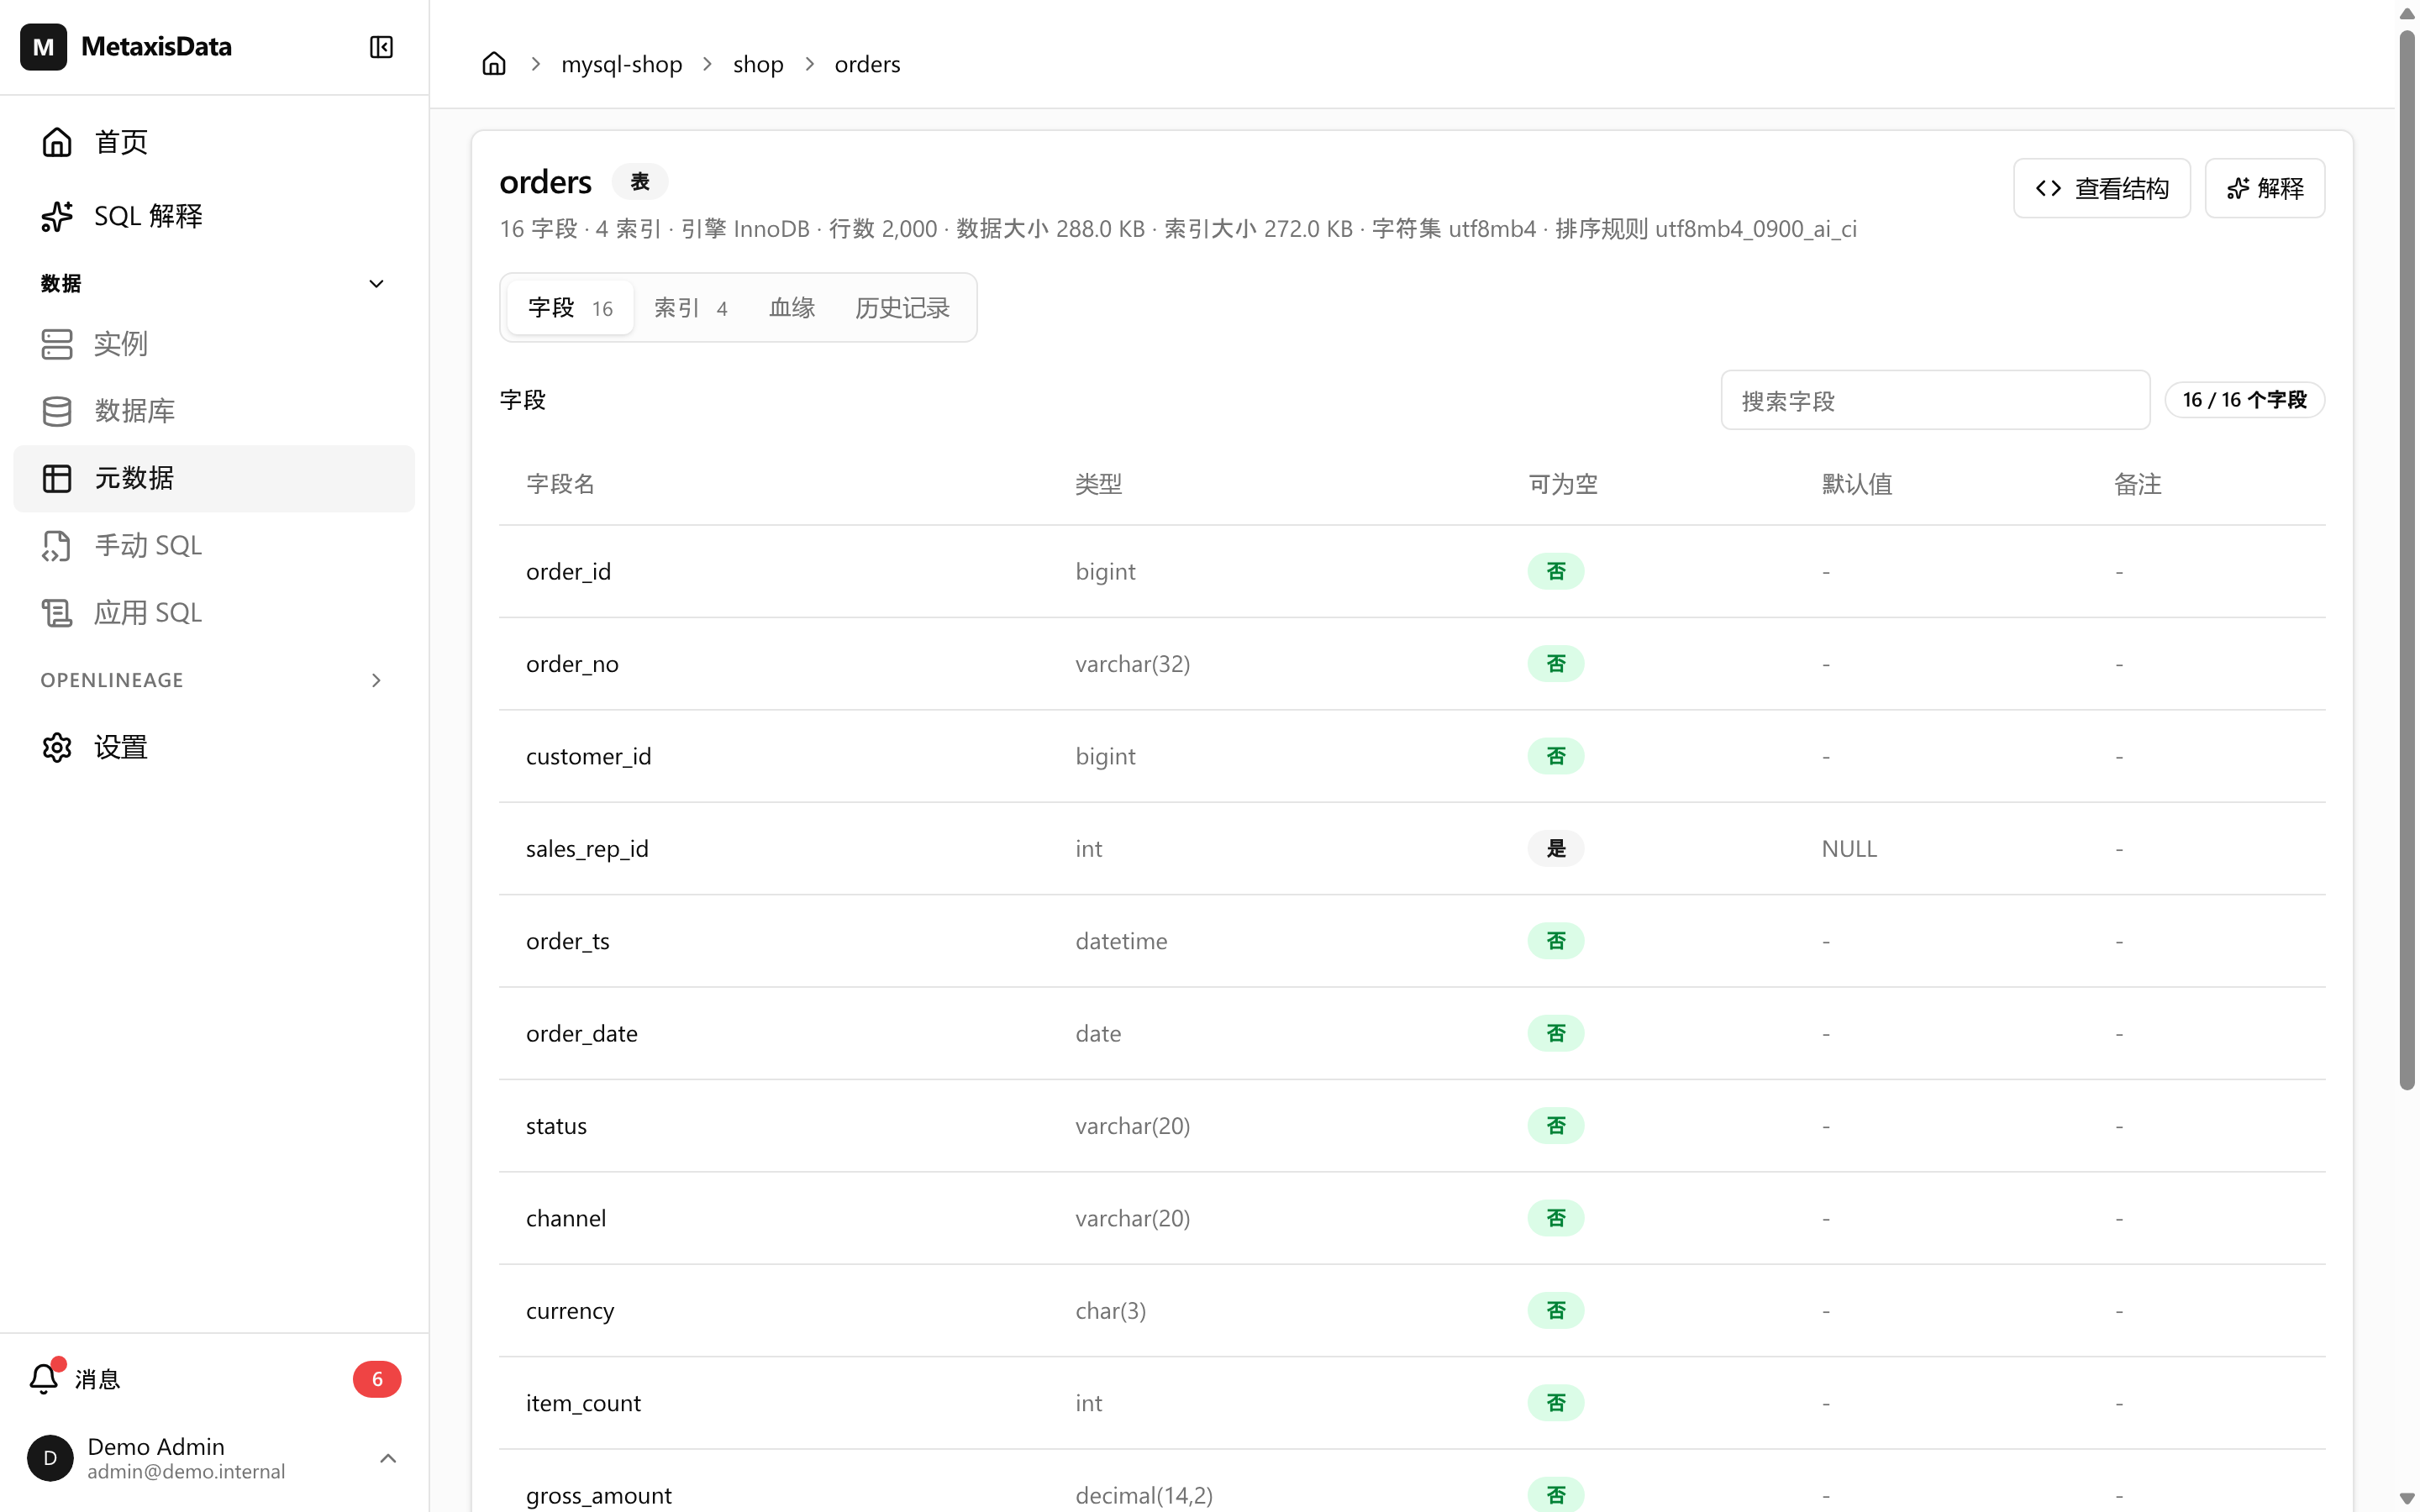
先看起点。这是一张再普通不过的订单表:16 个字段、4 个索引、2,000 行、数据 288 KB,引擎 InnoDB。
真正要看的是它下游。
把这张表的下游一次性展开,返回 33 个对象、399 条列级关系,最远到第六跳,横跨三个实例。下面这张图是同一条链的前几跳。
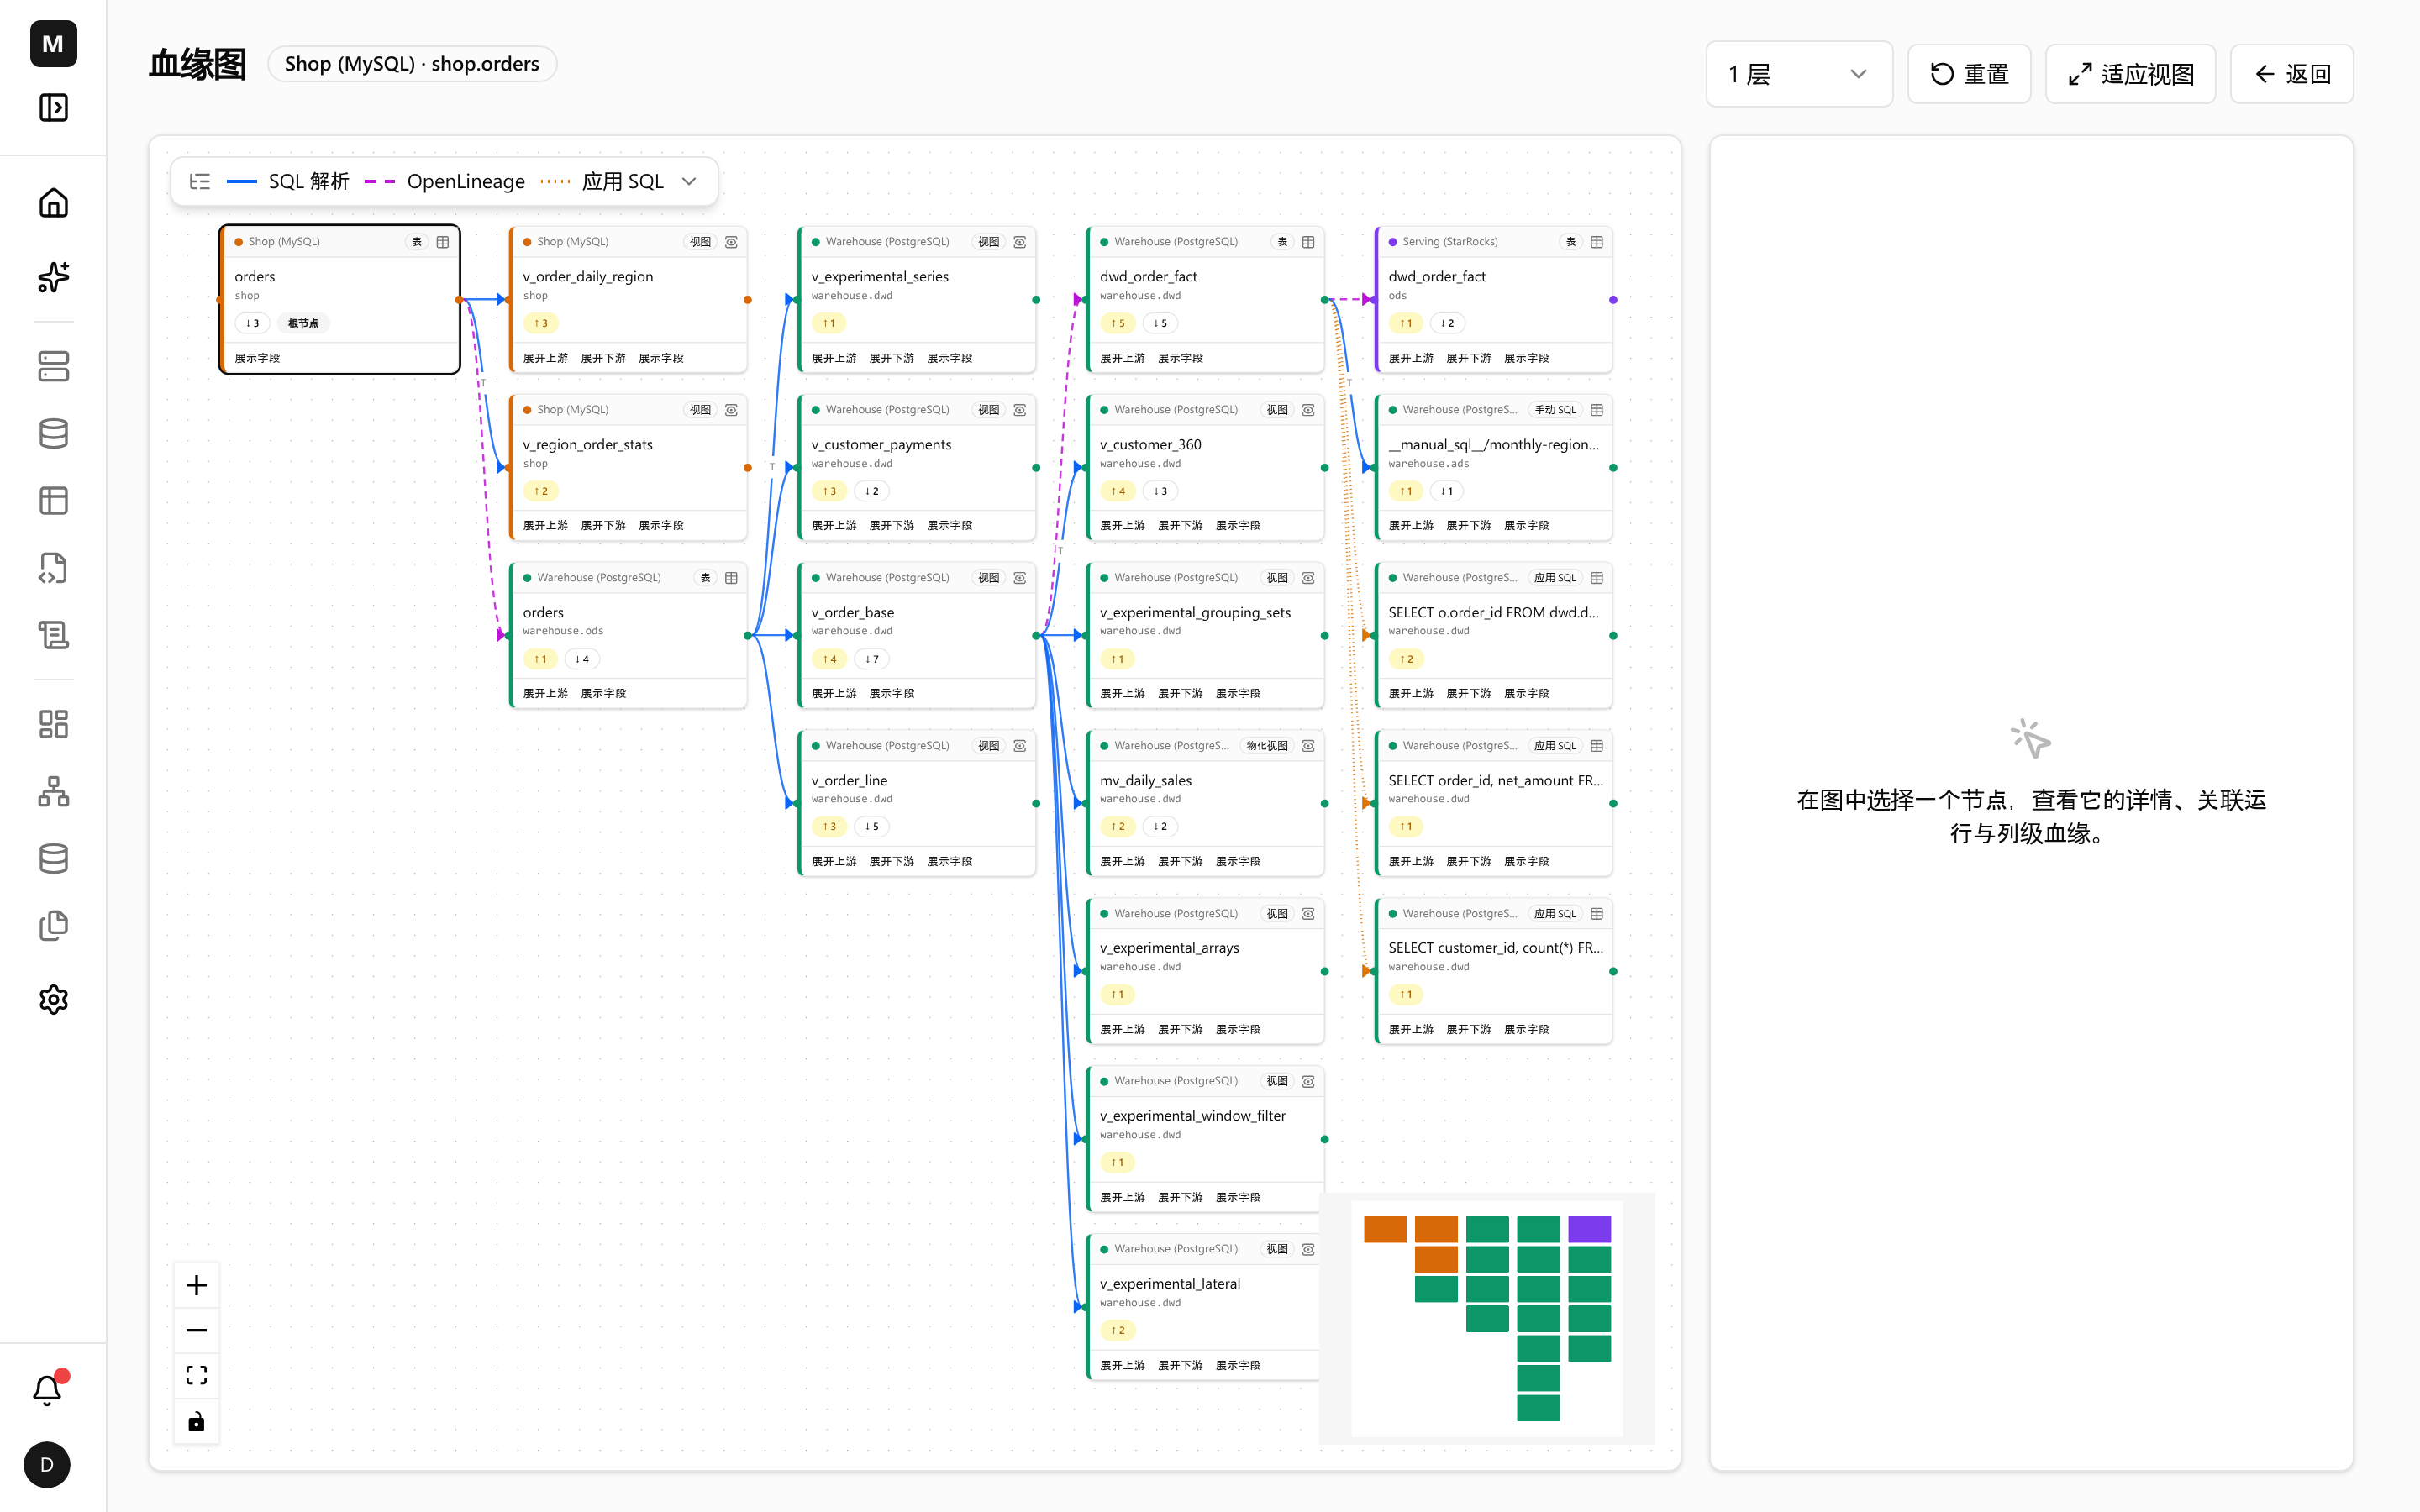
图里有三点值得停下来看:
- 每个节点左侧的色条是实例颜色。一条链从头走到尾,颜色换了两次。
-
边的颜色和线型一起表示这条关系来自哪里:SQL 解析出来的(视图、物化视图、手工
SQL)是实线,应用上报的语句是点线,调度器上报的运行事件(OpenLineage)是虚线。跨实例的每一跳都由调度事件接上——MySQL
到数仓那一跳来自一个叫
ingest_shop_to_warehouse.copy_orders的 Airflow 任务,数仓到服务层的几组边来自publish_to_serving下的五个发布任务。 - 图里混着几种平时不会被当成「依赖」的东西:一个手工 SQL 对象(有人写在 wiki 里的区域口径),三条应用上报的语句(应用实际执行过的 SQL)。它们都不在任何仓库里,却都在这张图上。
这些跨实例的边,靠事件里的命名空间认路:通常按主机和端口自动匹配到你的实例,匹配不上时手工映射一次,之后一直有效。
主链大致是这样(对象名都是真的):
shop.orders (MySQL) └─ Airflow: ingest_shop_to_warehouse.copy_orderswarehouse.ods.orders (PostgreSQL) ├─ warehouse.dwd.v_order_base │ ├─ warehouse.dwd.dwd_order_fact │ │ └─ warehouse.ads.__manual_sql__/monthly-regional-revenue │ │ └─ warehouse.ads.ads_daily_sales │ └─ warehouse.dwd.mv_daily_sales └─ warehouse.dwd.v_order_line └─ warehouse.dwd.mv_daily_salesstarrocks.ods.ads_daily_sales (StarRocks) └─ starrocks.ads.v_sr_sales_band
外加一串旁支:v_customer_360、dwd_customer_360、ads_customer_segment、ads_daily_sales,以及五个实验性视图;其中 dwd_customer_360、ads_customer_segment、ads_daily_sales
在 StarRocks 上各有一张镜像表。
也就是说:在商城仓库里改一个字段,可能一路走到第六跳——跨过另一套引擎,最后落在另一个人维护的一张报表上。而这条路径上没有任何一处会提醒你。
一个字段真正波及到哪里
表级已经够吓人了,但真正要回答的是列级的问题:我改的是 net_amount,谁会挂?
同一张图,换成以字段为单位看:选中 net_amount,画布上就只剩下这一列的流向。
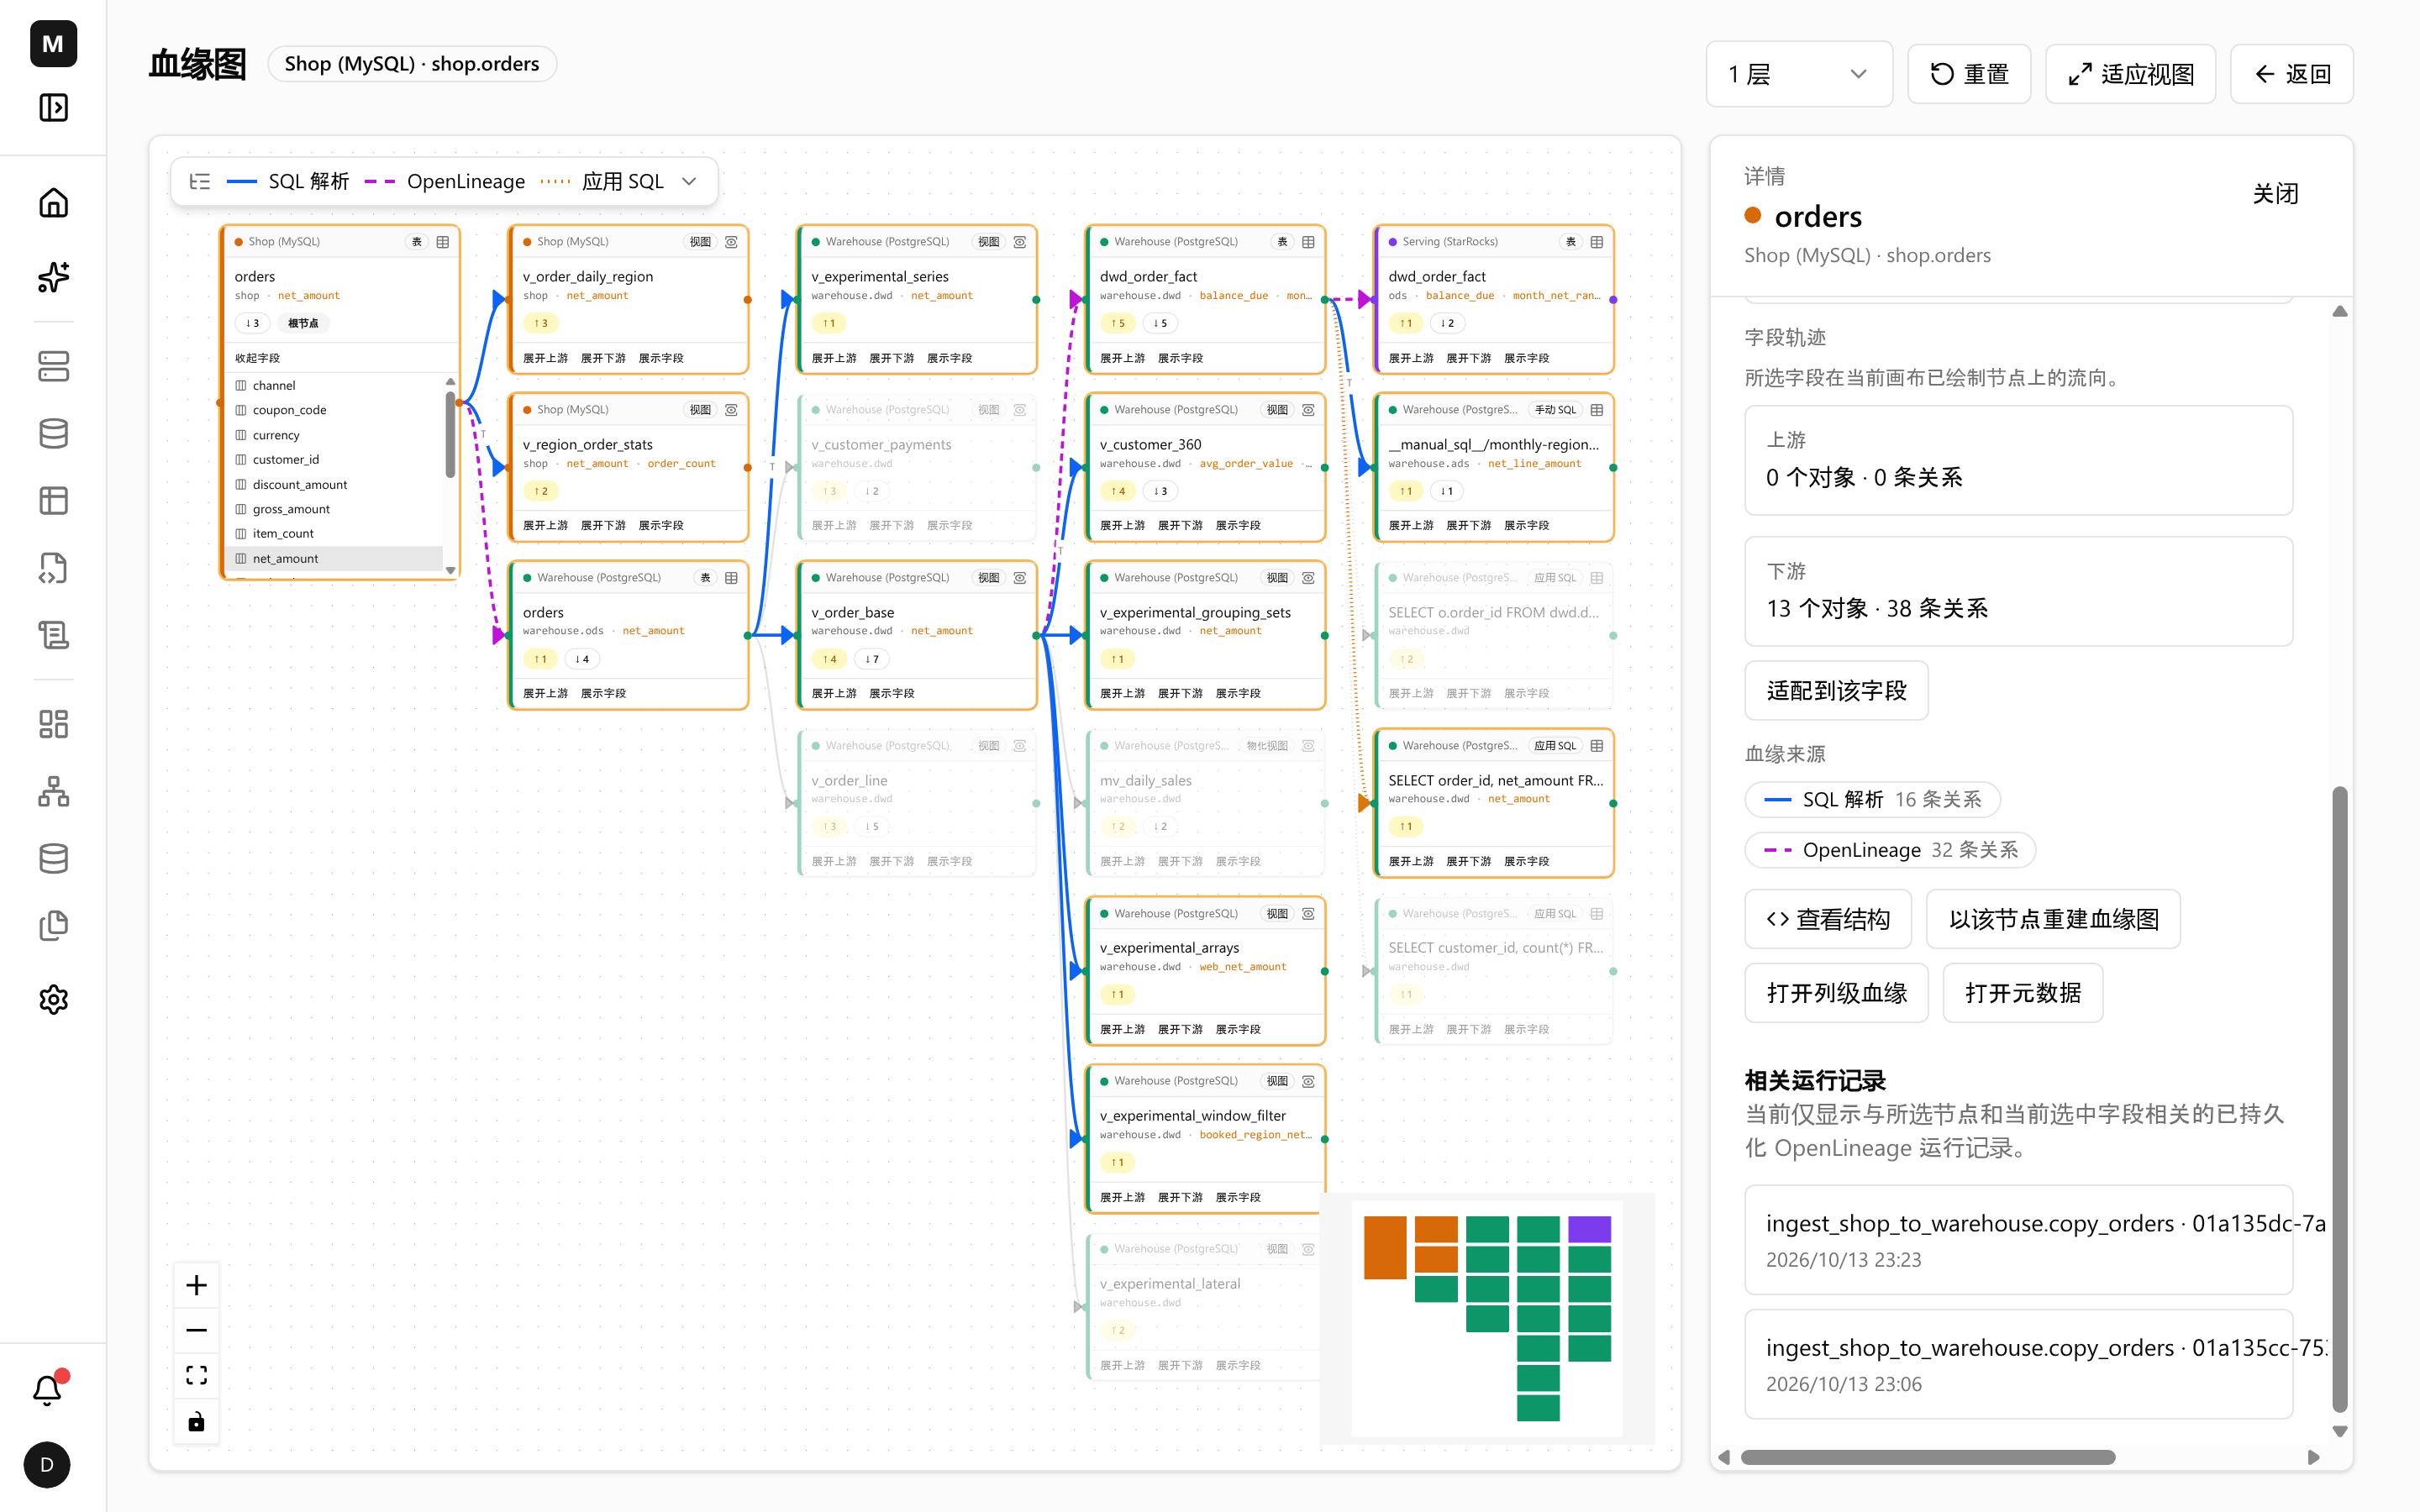
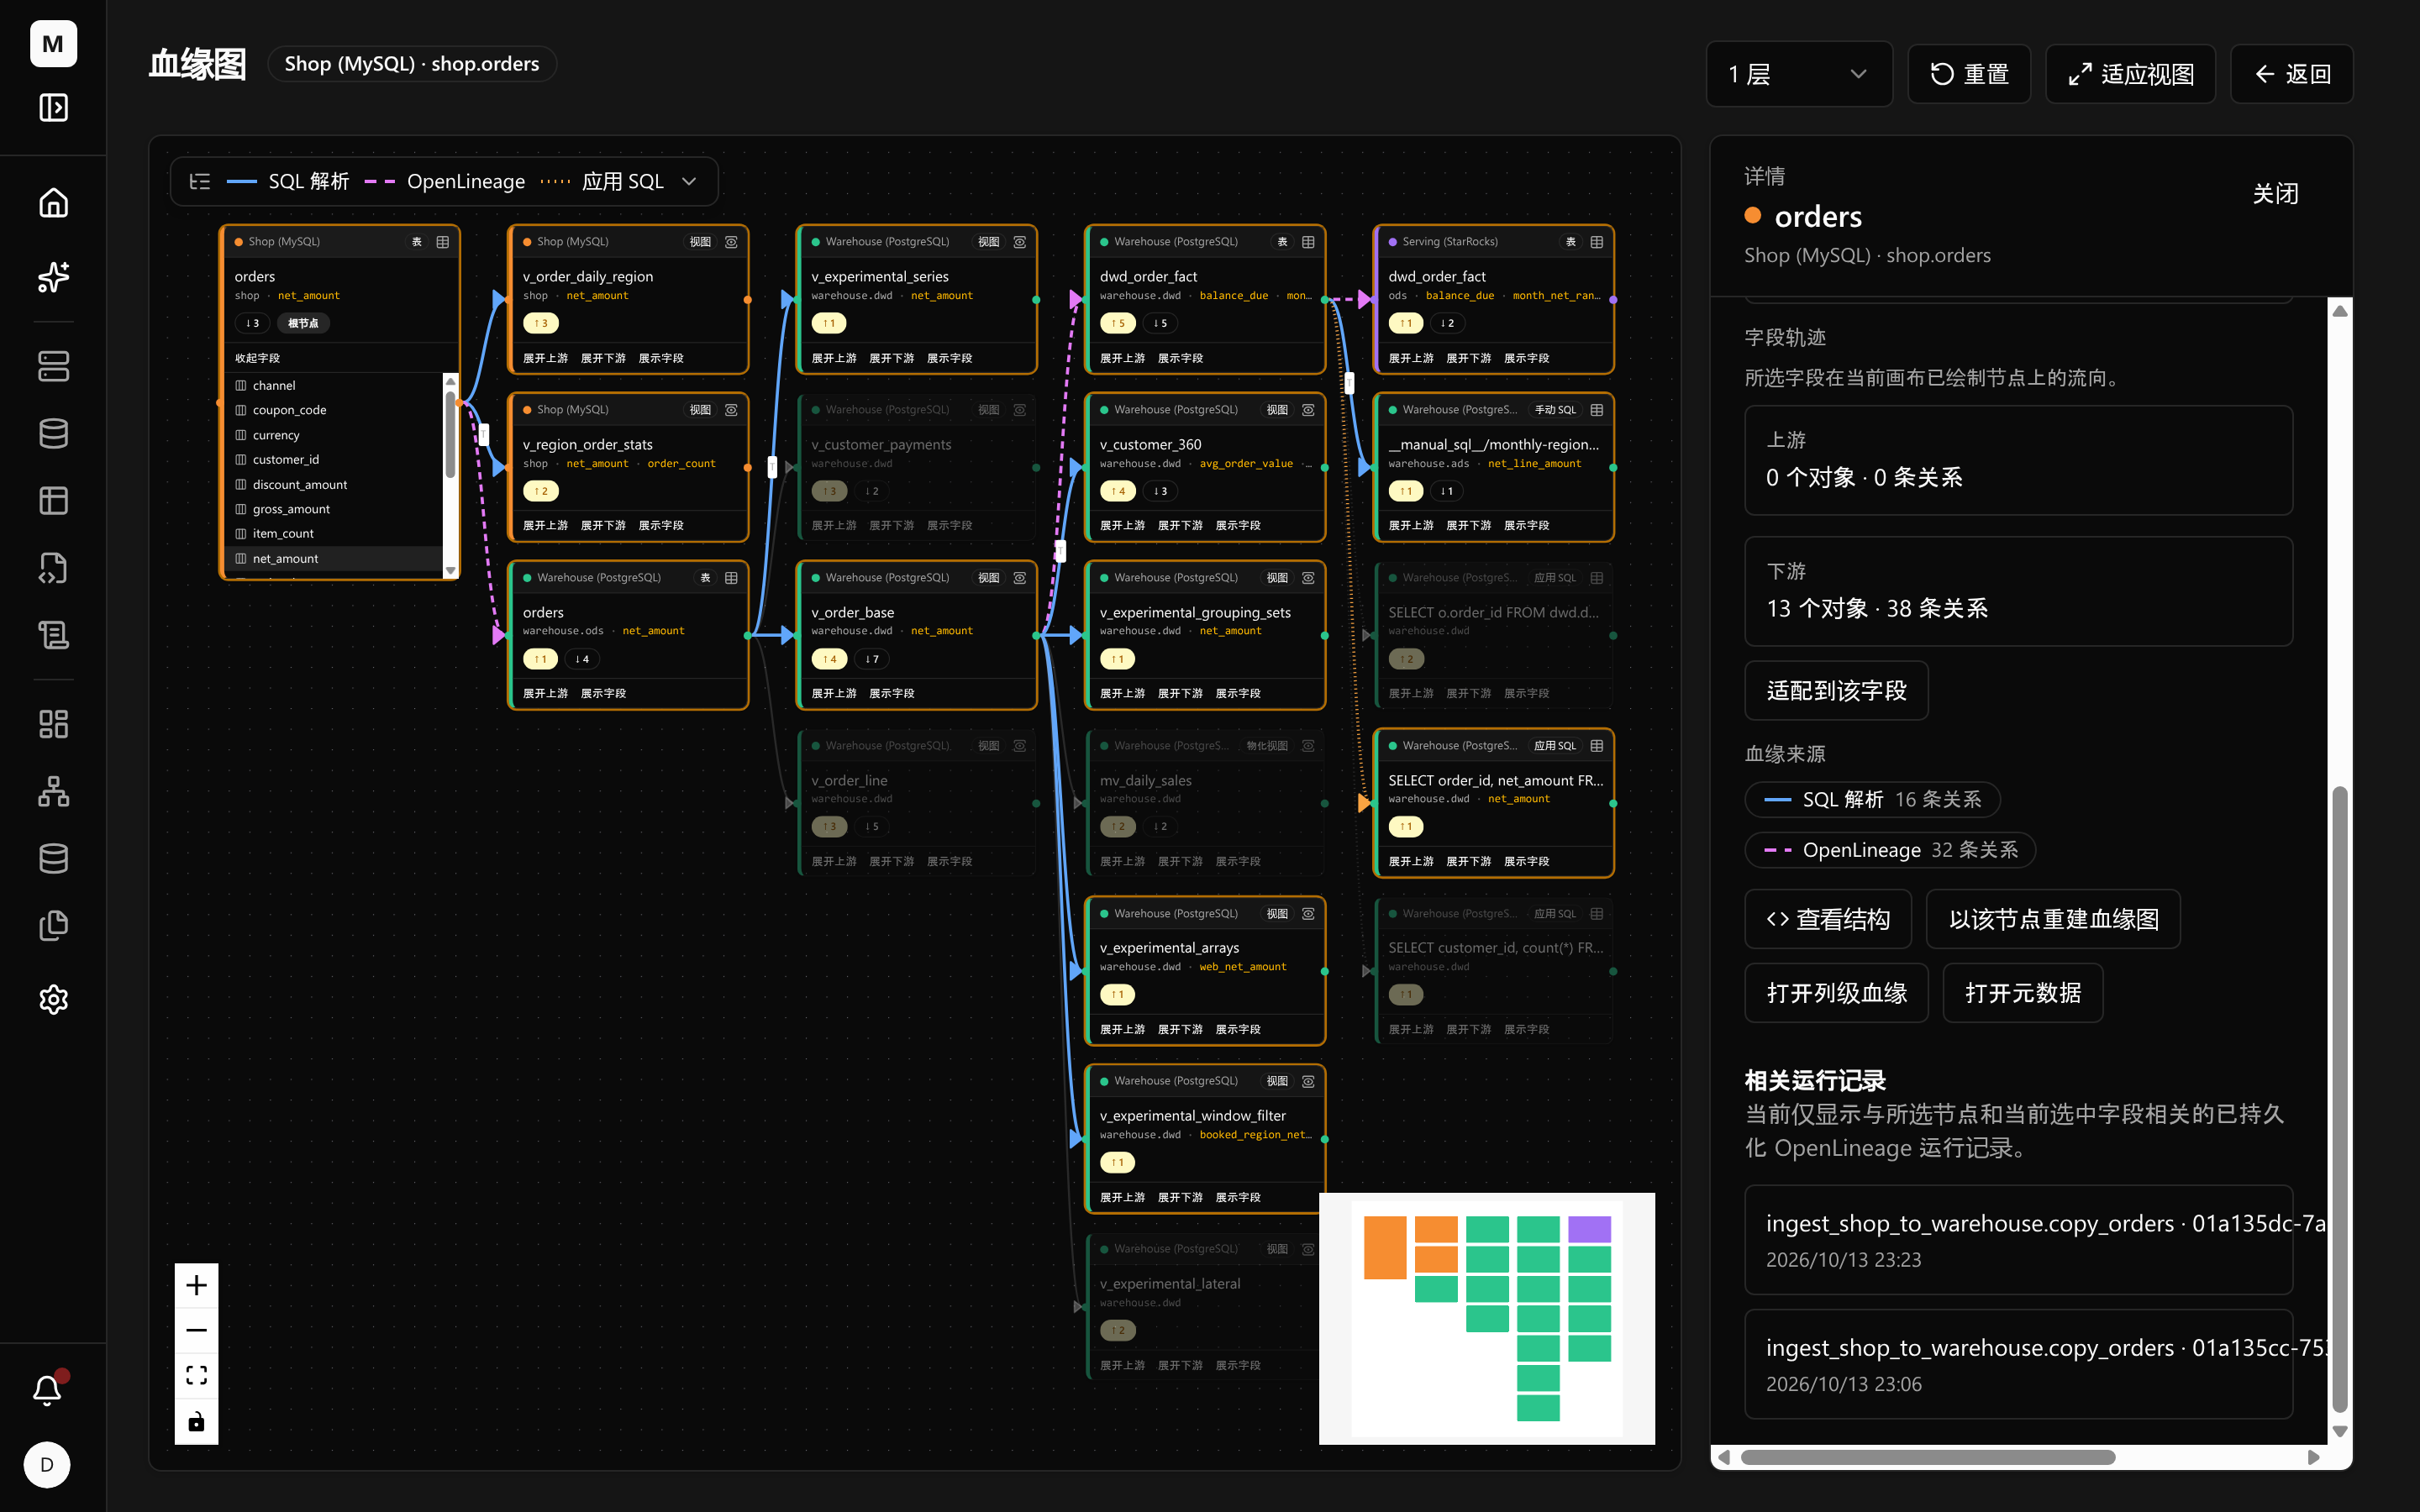
几个只有到列级才看得见的细节:
-
这一列到了
dwd_order_fact里同时喂给 4 个字段:net_amount、balance_due、payment_coverage、month_net_rank。 -
在
v_customer_360里,它参与算出了lifetime_net、avg_order_value、collection_rate,以及一个叫is_vip的客户分层标签——一个标签的命运,取决于这一列。 -
到了服务层,
v_sr_channel_region用这一列算出revenue_tier;物化视图mv_sr_region_daily则把这一列按订单日期、区域、渠道sum()起来。
还有一层是「怎么变的」:每条关系都带着变换信息——原样传递、聚合,或者只是拿来当连接键。算子一级的细节,决定了改这一列之后要不要同步改口径。
让 Agent 自己问:MCP 上的只读工具
上面这些能力,如果只能靠人点界面,就递不到真正动手的那一方手里——因为改代码的是 Agent,而 Agent 不会打开浏览器。
所以这个平台把注册中心做成一组只读工具,通过 MCP(Model Context Protocol)开放出来。启用之后,端点挂在同一个端口上,用 OAuth 2.1 授权(强制 PKCE),令牌绑定到这个端点本身,权限是工作区级的只读。客户端配置就这一段:
{ "mcpServers": { "metaxisdata": { "type": "http", "url": "https://mx.example.com/mcp" } }}九个工具,覆盖了一次变更评审要问的那些问题:列出实例、列出数据库、按名字找对象、看一个对象的直接子项或完整结构、取 DDL、分析一条任意 SQL 读了什么写了什么、拿到以某个对象为中心的多层血缘图,以及确认自己是谁。全部只读,没有任何写操作。
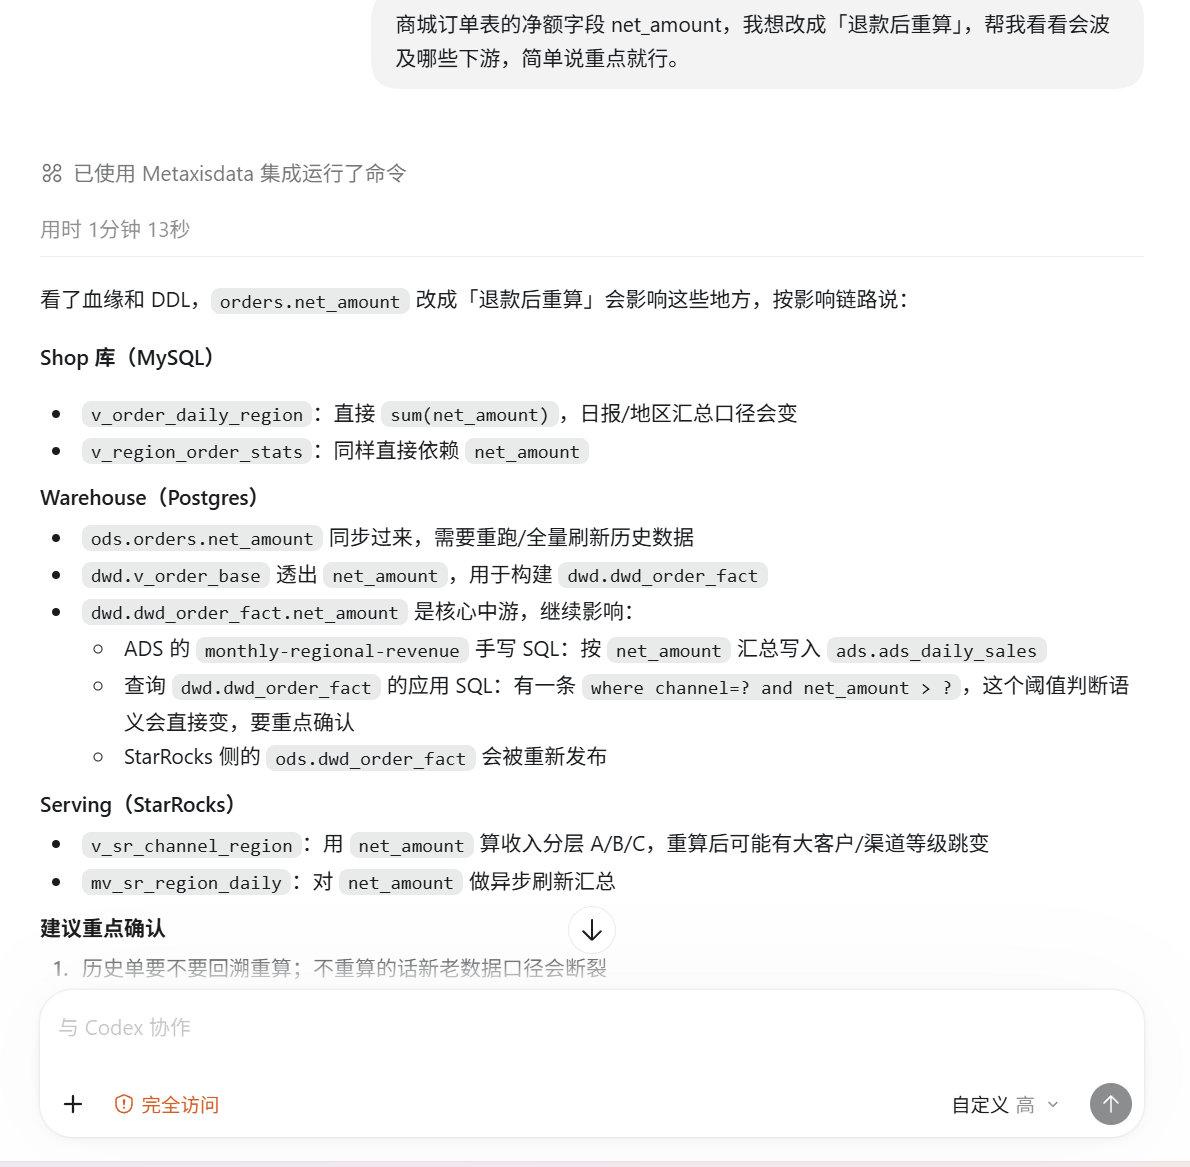
交给 Agent 就是这样:一句「商城订单表的净额字段 net_amount,我想改成退款后重算」,它自己找到实例、表和列,把影响按系统列出来——业务库的视图、数仓的 ods / dwd、服务层的物化视图,连写在这些系统外面的手工 SQL 和应用 SQL 都点到了。
回到我们的问题。Agent 要问的就是这一句:
{ "jsonrpc": "2.0", "id": 5, "method": "tools/call", "params": { "name": "get_lineage_graph", "arguments": { "object": { "instance": "mysql-shop", "database": "shop", "name": "orders" }, "direction": "down", "depth": 10, "column": "net_amount" } }}这次调用返回 16 个对象、29 条列级关系,仍然横跨三套引擎。返回的是机器可读的 JSON,摘一段真实返回——跨实例的那条边:
{ "sourceGuid": "mysql-shop;shop;;orders", "sourceColumn": "net_amount", "targetGuid": "postgres-warehouse;warehouse;ods;orders", "targetColumn": "net_amount", "relationType": "DIRECT", "metaGuid": "openlineage:run:TASK:default:ingest_shop_to_warehouse.copy_orders:..."}以及链路最远端的一次聚合:
{ "sourceGuid": "starrocks-serving;ods;;dwd_order_fact", "sourceColumn": "net_amount", "targetGuid": "starrocks-serving;ads;;mv_sr_region_daily", "targetColumn": "net_amount", "relationType": "GROUP", "transformations": [ { "operation": "AGGREGATE", "expression": "sum(net_amount)", "functionName": "SUM", "groupKeys": ["order_date", "region", "channel"] } ]}
注意 relationType:DIRECT 表示原样传递,GROUP 表示被聚合;经过变换的标 INDIRECT,拿来当连接键的标 JOIN——连接键动的是结果集,不是某一列的值。这些标注决定了「改这一列到底意味着什么」:改一个只被原样传递的列,动的是值;改一个连接键,动的是结果集。
还有一件容易被忽略的事:每一次调用都会留痕。审计日志记着工具名、调用者、请求参数,以及耗时和成败,只读查询也一样。
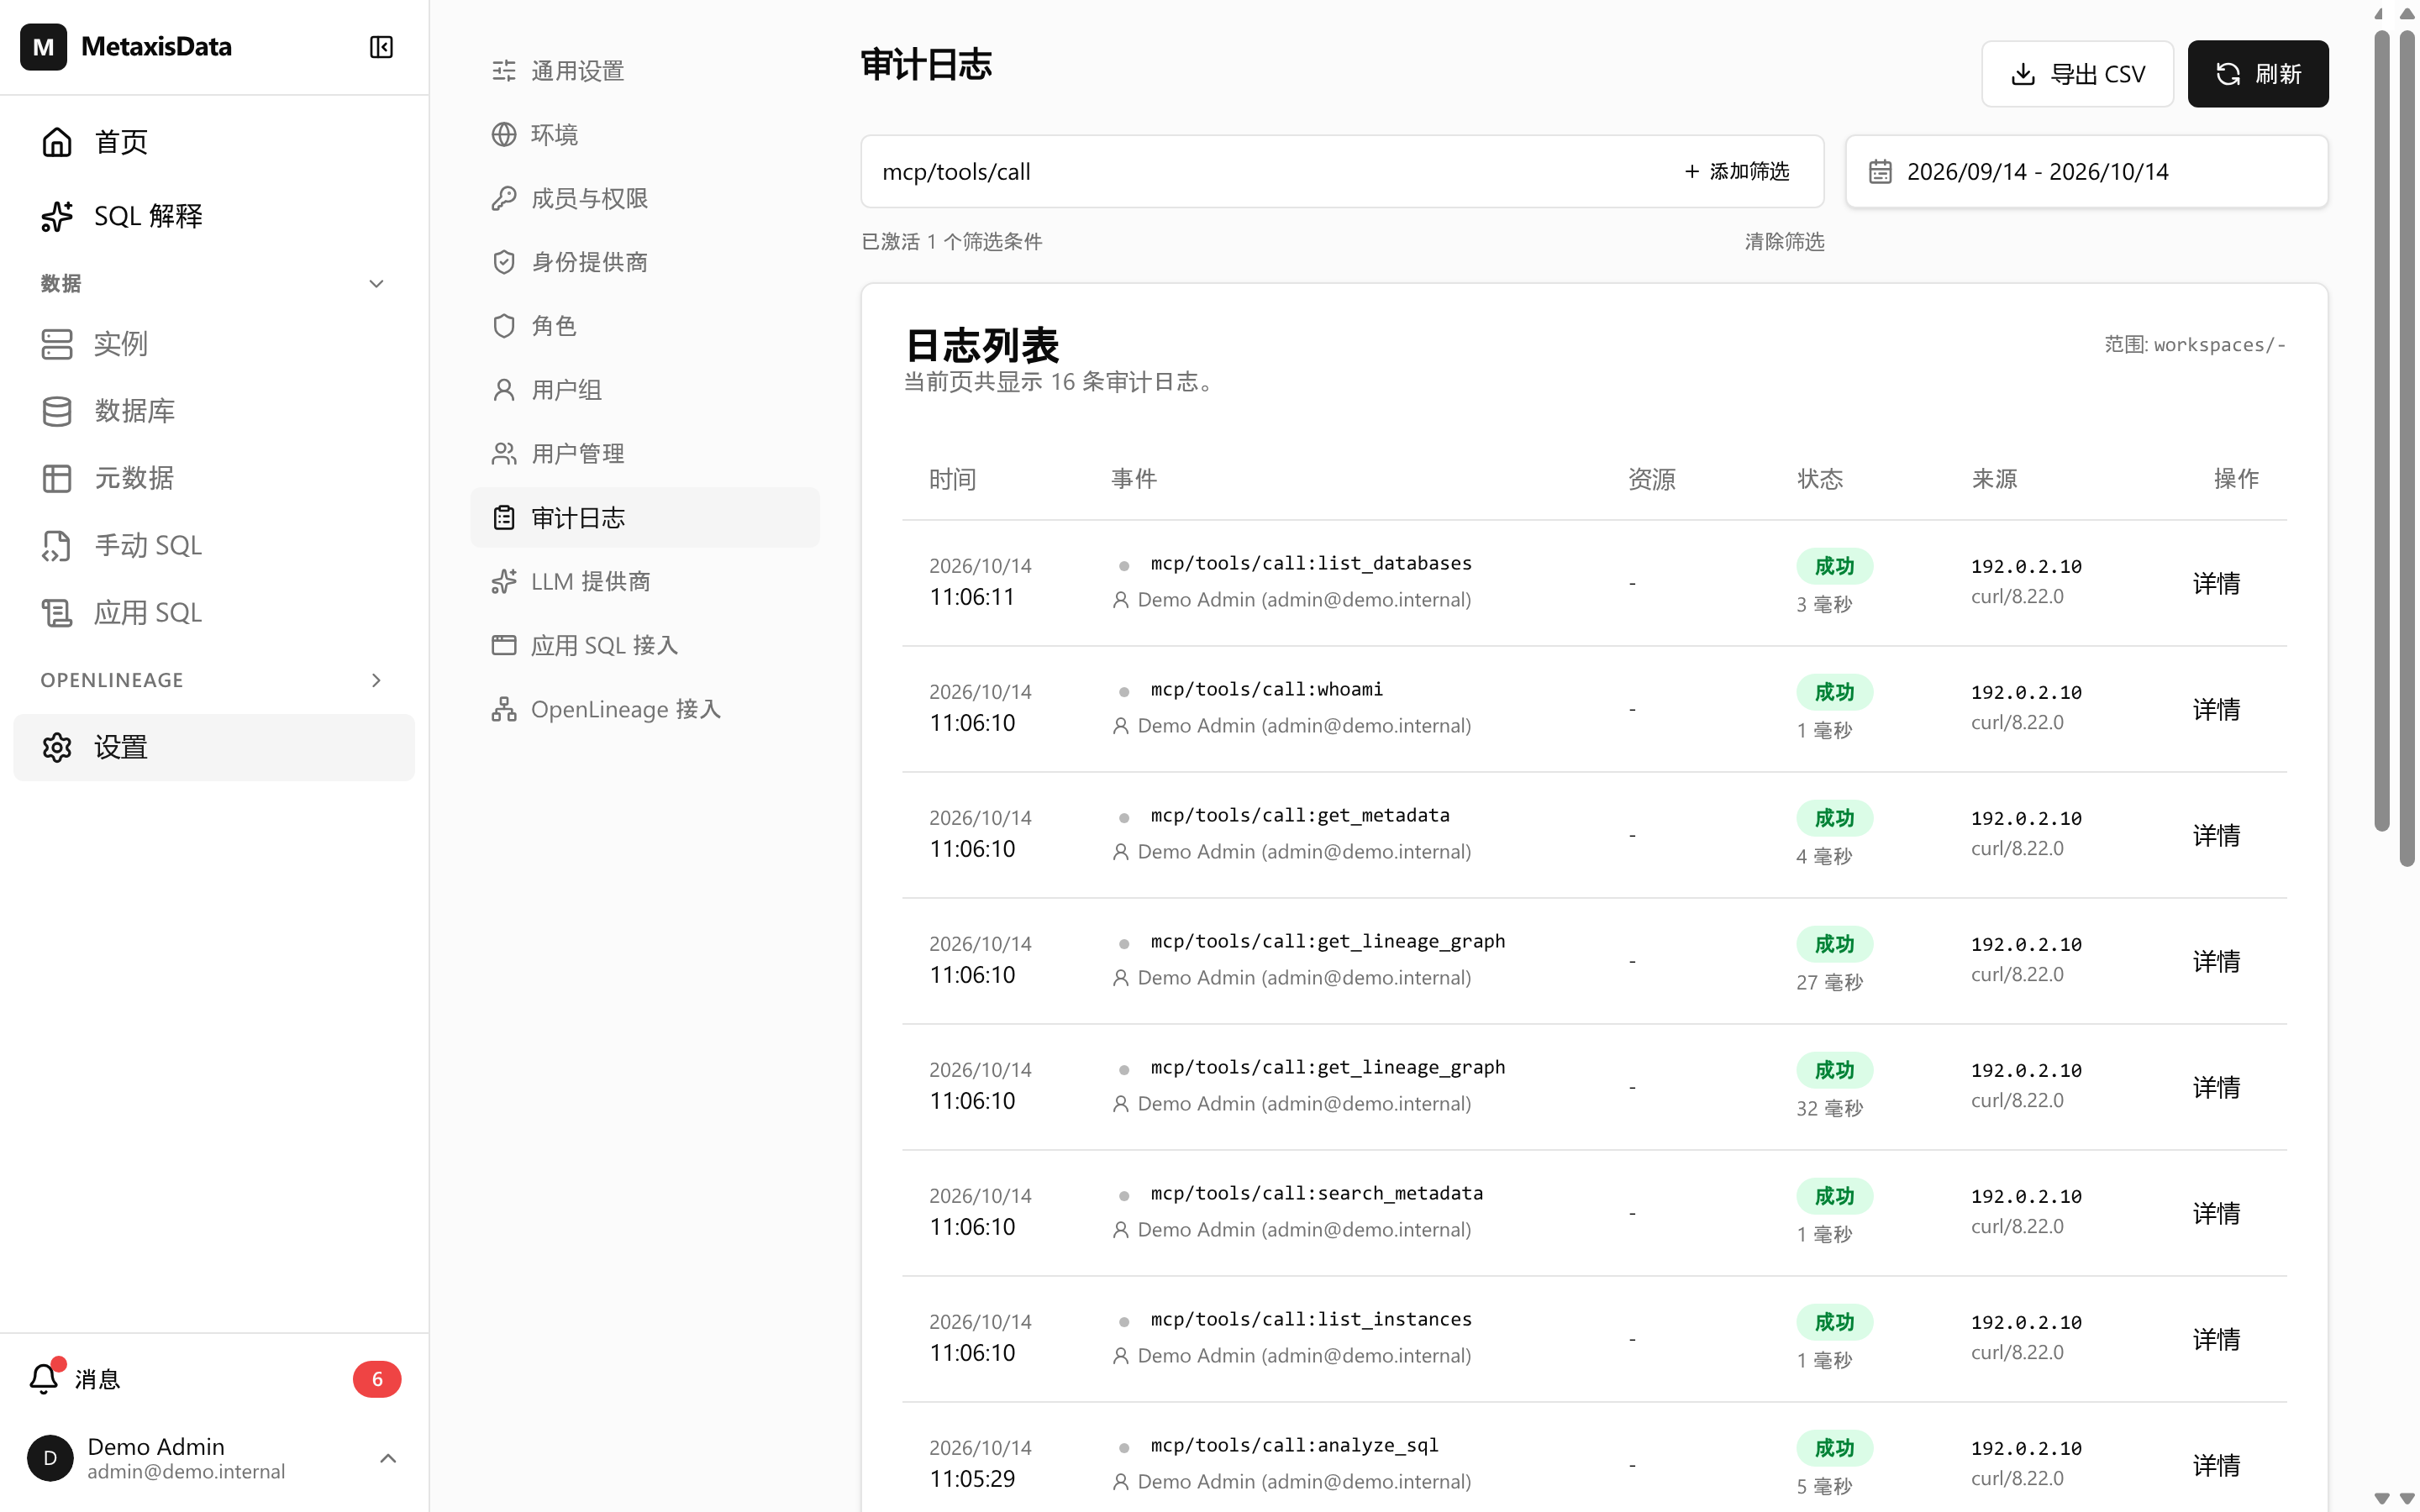
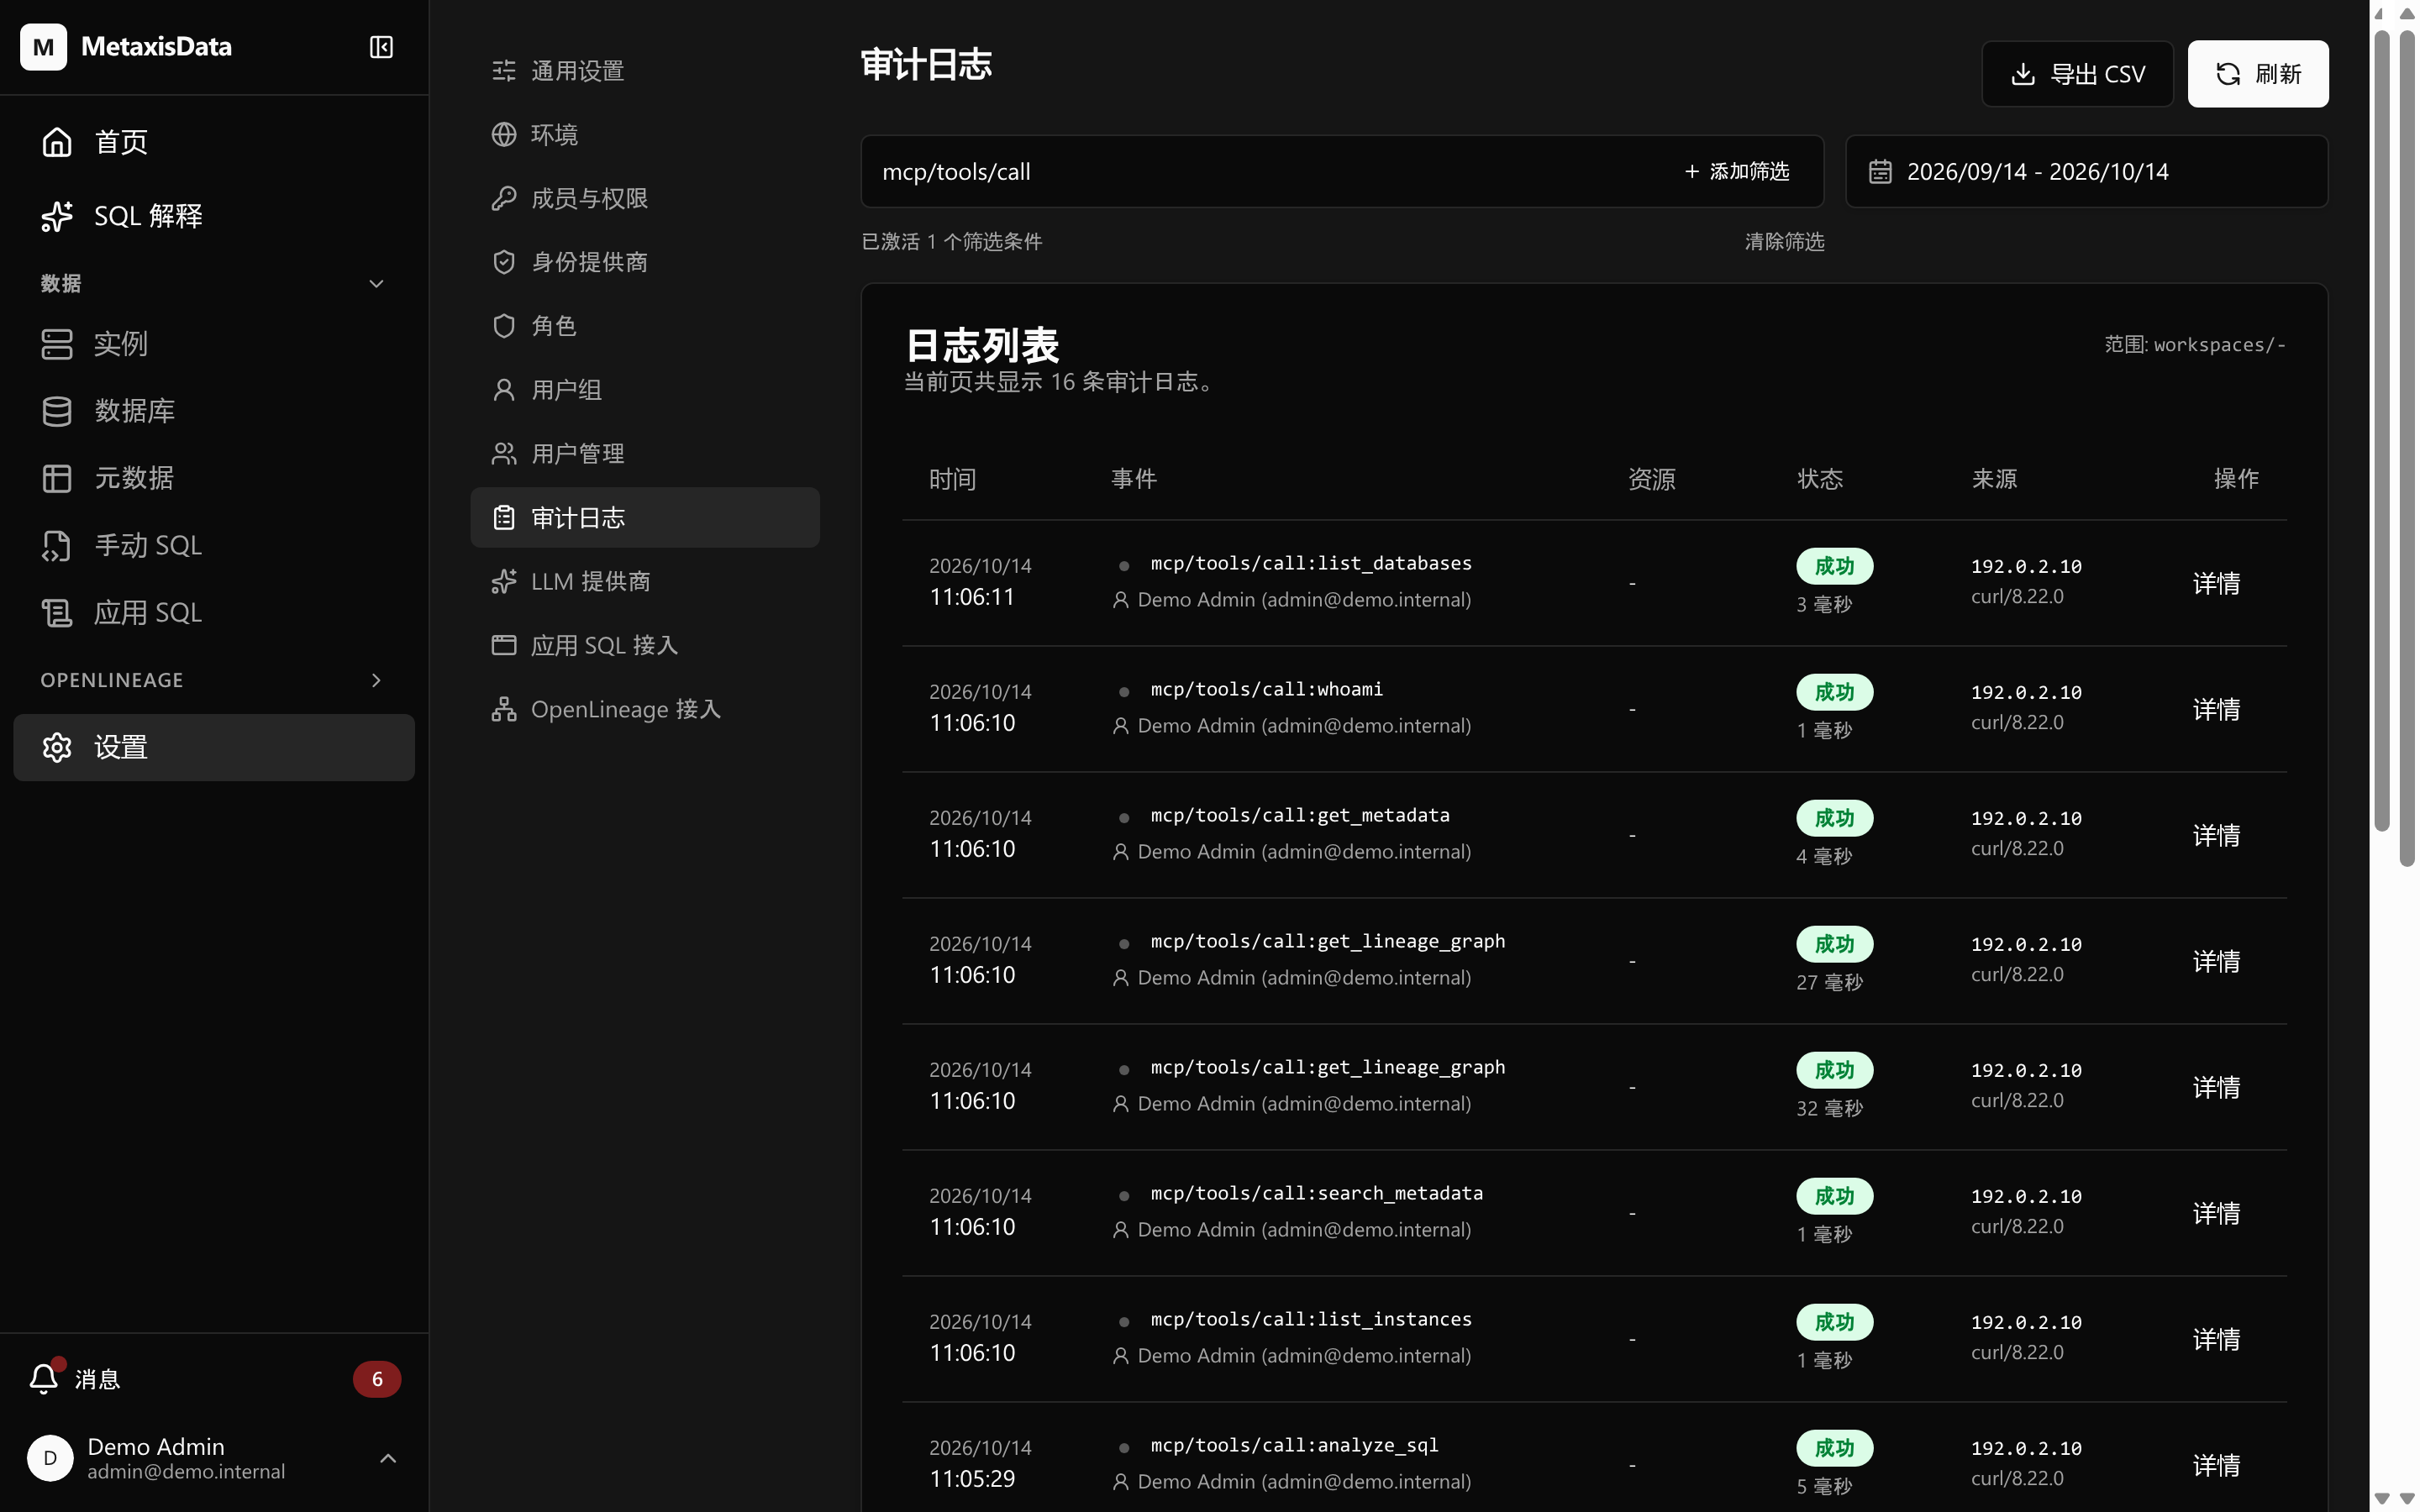
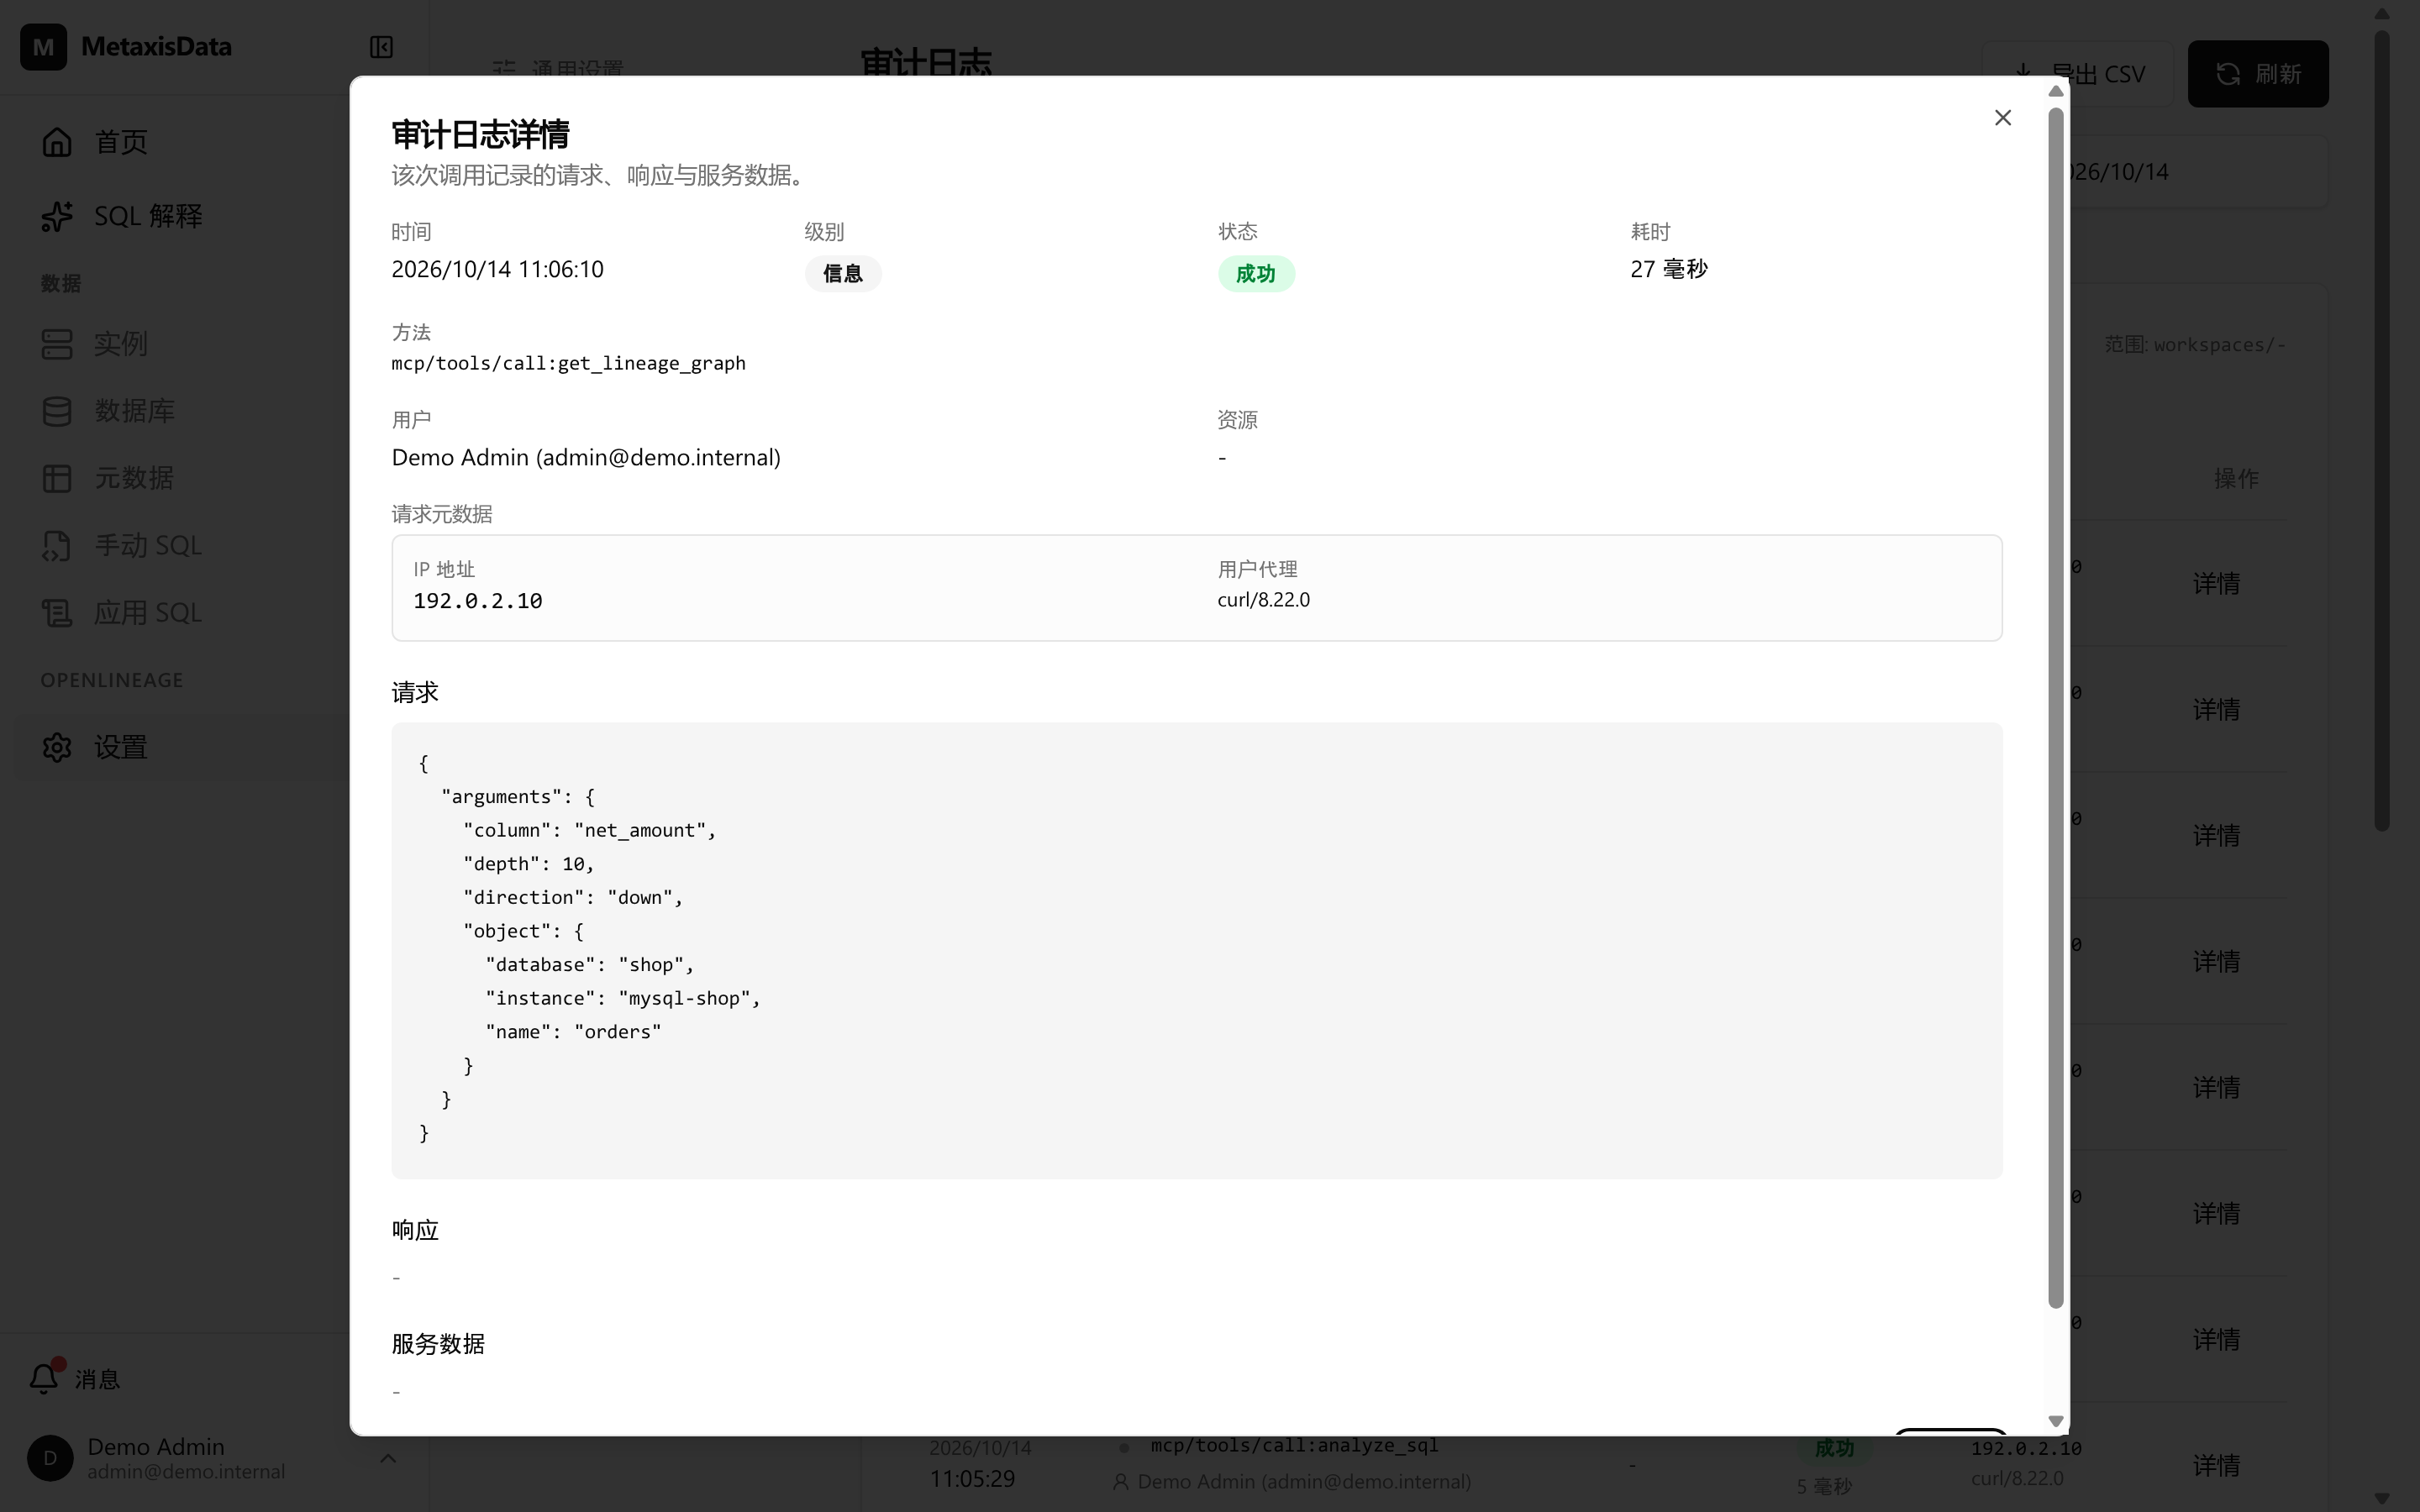
你能看到 Agent 问过什么、凭什么下的判断;反过来,一次变更之前到底有没有人问过依赖,也查得出来。
把它接进开发循环
工具就位之后,剩下的是流程。四条规则,从便宜到贵:
- 在指令里写死。给 Agent
的系统提示里加一句:「修改任何表结构、列名或列类型之前,先用
get_lineage_graph查询该列的下游影响(direction: "down"、depth: 6、column: "<列名>"),把返回的对象清单写进 PR 描述。」 - 把影响清单当成评审材料。评审的人需要看的不是 diff,而是「这次改动会碰到谁」。一份 30 多个对象的清单,比一百行 SQL 更容易看出问题。
- 在 CI 里做一次检查。对本次改动涉及的字段名跑一遍同样的查询;下游对象数不为零、又没有人工确认时,让流水线要求一个显式豁免。
- 把口径也纳进来。那些写在 wiki 和报表工具里的 SQL,可以登记成手工 SQL 对象,它们和其他对象一样进图、一样参与影响分析——口径不用再单独维护一套。
为什么可以放心交给 Agent
- 它只读。不会执行迁移,也不会写回任何实例——你交给 Agent 的是答案,不是写权限。迁移脚本仍然由你和你的 Agent 写,平台负责在动手之前把影响面摆出来。
- 数据不出你的基础设施。一个二进制加一个 PostgreSQL:元数据、血缘、各实例的连接凭据都留在这个库里,凭据还可以加密——设了密钥之后,单凭一份数据库转储也解不开它们。它读的是 schema,不是数据,没有任何行值会进注册中心。
- 每一次调用都留痕。上面那两条审计记录就是它日常的样子;令牌是工作区级的只读令牌,随时可以吊销。谁在什么时候问过什么,事后都查得到。
- 它不猜。解析不了的语句会给出诊断——哪个引用没解析出来、哪种语句形状还不支持——而不是编一条看起来合理的边给你。
- 它现在支持这些引擎。血缘分析覆盖 MySQL、TiDB、MariaDB、PostgreSQL 与 StarRocks,schema 同步支持的面更宽(含 SQL Server);其他数据库类型的血缘分析正在快速开发中。
五分钟拿到第一个答案
- 起一个服务端:用页尾那段 docker 命令,需要 Docker 和一个容器可达的 PostgreSQL。
- 建第一个账号,添加一个实例,同步它的 schema(完整步骤见 快速上手)。同步完成后,实例里每张表的真实元数据——字段、索引、行数、DDL、变更历史——就都在了。
- 在设置里打开 MCP,把它填进你的 MCP 客户端配置(授权流程与配置样例见 接入 MCP 客户端)。
然后,挑一张你最担心的表,问一个问题:如果我把这一列改掉,谁会挂?
想先看看三套引擎串起来的样子,可以拉一个现成的演示环境( metaxisdata_demo):MySQL、PostgreSQL、StarRocks 加四条 Airflow 管道,数据和血缘都已经准备好,一条命令拉起。
拿你自己的 schema 跑一遍
起服务端、加一个实例、打开 MCP——三步就能在你自己的实例上得到第一个答案。想先看演示环境,一条命令就能拉起。
docker run -d --name metaxisdata \ -p 8083:8083 \ -e PG_URL='postgres://user:password@db-host:5432/metaxisdata?sslmode=disable' \ ghcr.io/ranxy/metaxisdata:latest